Ты копируешь вчерашний запрос в новый чат и читаешь другой ответ. За час такой переписки легко решить, что виновата формулировка. Слова запроса на экране те же, а в окне уже другой набор. Свои правила, кейсы и критерии туда снова не попали. Чат между сессиями сам ничего не помнит, и текст усредняется. Ниже покажу, что держать вне чата и как принимать черновик по своим критериям.
Контекст одного вызова это токены, которые модель видит прямо сейчас. Формулировка запроса внутри этого набора остаётся рабочим слоем. Голос держит сборка снаружи: правила, свои материалы, критерии и человек на приёмке. Длинное окно, чужая оценка и граф по корпусу эту приёмку не заменяют.
Anthropic 29 сентября 2025 описывает контекст как набор токенов на один вызов. Инженерия этого набора в их тексте про отбор и поддержку, а промпт назван слоем внутри. Ориентир команды: наименьший набор сильных токенов. С ростом окна нужное вспоминается хуже, они зовут это гниением контекста (context rot). Это наблюдение команды, не замер рынка экспертов.
Один запрос в двух окнах
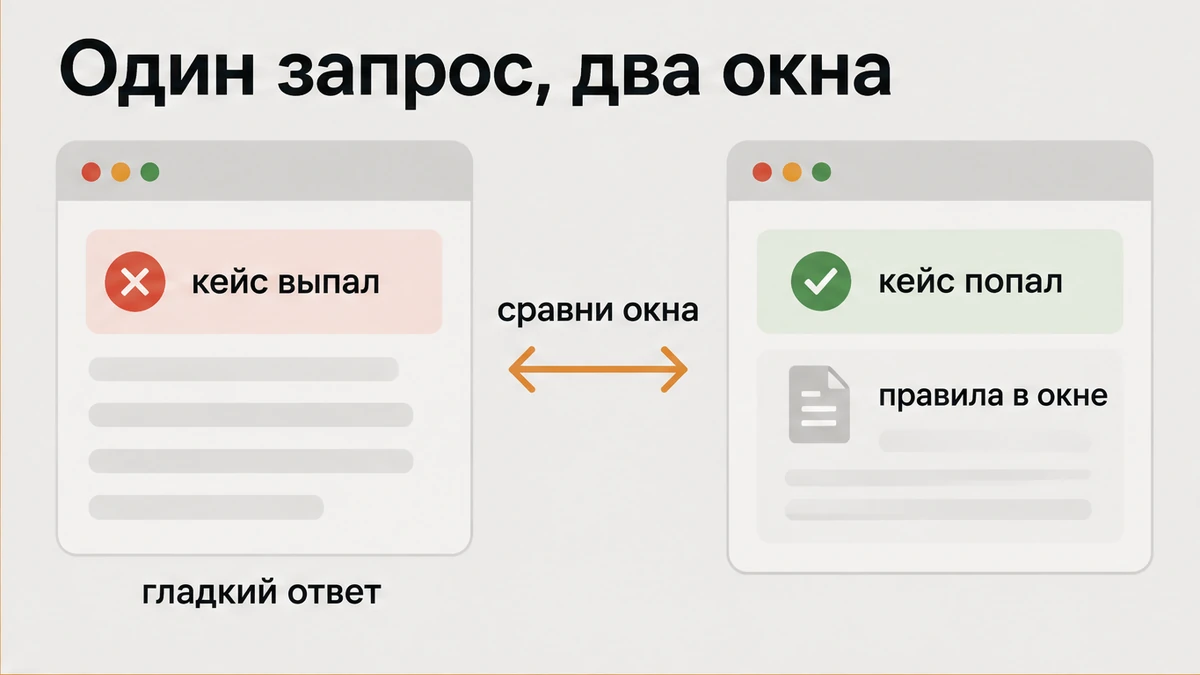
Вчерашний текст запроса ты уже видел. Сегодня модель отвечает иначе, потому что в окне лежит другой набор. Между сессиями она состояние не хранит. В инженерном разборе Яндекса от 13 августа 2026 прямо сказано: память о фактах, поиск по документам и кеш похожих ответов это разные задачи. Это текст вендора, не норма всего рынка.
Сделай простую проверку в двух чистых сессиях. Прогони один текст запроса в каждой и сравни, какие правила в ответ не попали. Во втором чате кейс часто выпадает, и ответ становится гладким. Если список длинный, окно снова собрано почти с нуля.
Длинное окно память не чинит

Большое окно легко принять за память эксперта. На деле с ростом набора нужный кусок вспоминается хуже. Команда Anthropic называет это гниением контекста и не выдаёт наблюдение за замер рынка. Заявленный размер окна и рабочий диапазон тоже расходятся.
Modarressi и соавторы на ICML 2025 проверяли 13 моделей с большим окном. У всех тринадцати заявленное окно начиналось от 128 тысяч токенов. На длине 32 тысячи токенов 11 из них падают до половины короткого результата и ниже, если нет буквального совпадения слов. Это синтетическая игла из лабораторной проверки, к контенту эксперта она не относится. GPT-4o в той работе падает с 99,3% до 69,7%, и окно всё равно конечно. Сверяй ответ со своими критериями и не меряй качество длиной окна.
Повторяемое вынеси в одну базу

Правила, которые ты каждый раз копируешь в запрос, лучше лежат в одном месте. Иначе каждый новый чат собирает голос заново и снова его усредняет. Lewis и соавторы на NeurIPS 2020 показали внешнюю память на плотном индексе Википедии. Текст с ней выходил конкретнее и фактологичнее, чем у модели только на параметрах. Эту память можно заменить целиком и так обновить знания.
Обещания текста без выдумок там нет, и к личному бренду работа напрямую не относится. Повторяемое вынеси в одну базу и напиши, кто её владелец. В окно клади только то, без чего ответ перестаёт быть твоим. Весь архив пусть лежит в базе и ждёт нужный этому запросу кусок.
Такую сборку я называю KiRAN Praxis. Для меня это имя собственного метода. Отраслевым стандартом консалтинга я его не объявляю. Посмотреть, как база эксперта живёт вне чата, можно на KiRAN Praxis. Если нужна сборка под твою задачу, напиши через страницу услуг.
Прими черновик своими критериями
Цифру уверенности легко принять за проверку голоса. Liu и соавторы в препринте смотрели словесную уверенность при подстановке внешних фрагментов. Средняя ошибка калибровки выше 0,4 на четырёх наборах данных. Противоречивые и посторонние фрагменты усиливают самоуверенность. Блок оценки уверенности не стандарт отрасли и сам систему не регулирует.
На семинаре SIGKDD 9 августа 2026 Abbasli и соавторы показывают слабое место одной общей оценки. Одна оценка на весь ответ смешивает верные и неверные утверждения. Калибровка по отдельным проверяемым фразам на фактах ошибку снижает. На ложной предпосылке сигнал ломается. Если в вопросе уже сидит кривая вводная, цифра спокойно подтвердит её.
Граф по корпусу тоже не стоит принимать за свой голос. Edge и соавторы в апреле 2024 строят граф сущностей и заранее пишут сводки сообществ для вопросов про весь корпус. На корпусах около миллиона токенов полнота и разнообразие ответов выше, чем у простого векторного поиска. Работ 2026, где это названо фундаментом личного бренда, в этой проверке нет.
Shahbaz Ali и соавторы в препринте от 1 октября 2026 гоняли повторное ранжирование клинических заметок. Попадание нужной заметки в первую десятку выросло с 46,6% до 60,6%. Средний взаимный ранг сдвинулся с 0,2371 до 0,3252, и верность судьи с 44,8% до 48,6%. На выборке было 1000 пар, 200 пациентов и модель Qwen3-8B. Лучше найденный фрагмент почти не поднял качество ответа. Домен там бариатрические карты, к бренду эксперта он не относится.
Человек принимает черновик по своим критериям. До следующего запуска запиши правило, без которого текст тебе не принадлежит. Рядом положи свой фрагмент, который обязан попасть в ответ. И подпиши имя того, кто говорит да или просит переписать.
Сверь, где сборка уже врёт
Сборка вне чата не держит твой голос, когда корпус чужой или уже протух и принять его некому. Там же фрагмент находился лучше, при этом ответ почти стоял на месте. На ложной предпосылке калибровка из работы Abbasli тоже рассыпается. Красивая внешняя память с чужим текстом снова даёт усреднённый тон.
Карим из NODA в разборе на vc от 3 октября 2026 пишет про клиентскую базу. Без одного владельца и живой приёмки она протухает. Квартал в его тексте это типичный горизонт практики, не измеренная константа. Его пример 28 из 30 это иллюстрация статуса, не замер. Как часто обновлять свою базу, эта статья не закрывает. Смотри по своим материалам и не копируй чужой горизонт.
Оставь формулировку рабочим слоем
Слой запроса выкидывать не нужно. И Anthropic, и спрос в Wordstat оставляют формулировку рабочей частью вызова. Автономного двойника, который сам ведёт бренд круглые сутки, эта статья не обещает. KiRAN Praxis нормой рынка от этого не становится. Ты по-прежнему пишешь разовый запрос, только уже поверх своей базы.
В поиске по-прежнему жива формулировка запроса. На срезе Wordstat от 3 октября 2026, регион 225, фраза промпт инжиниринг набирает 4085 показов. Рядом ии для эксперта даёт 560 показов, база знаний эксперта 309, личный бренд эксперта 199. Сборка того, что попадёт в окно, от этой формулировки отделена.
Собери минимальный набор до того, как откроешь чат: правила, которые повторяешь, несколько своих фрагментов и критерии готового текста. Потом покажи один разовый запрос поверх этого набора. Если база пустая, чужая или без владельца, ответ снова усреднится. Чужую оценку уверенности на место приёмки не ставь.
| Критерий | Разовый запрос | База вне чата | Оценка уверенности | Граф по корпусу |
|---|---|---|---|---|
| Что попадает в вызов | В вызов попадает только текущий набор токенов. | В базе заранее лежат правила, фрагменты и критерии. | На ответ садится одно число уверенности. | По корпусу заранее готовятся сводки сообществ. |
| Где схема ломается | Между сессиями состояние само не сохраняется. | Чужой или старый корпус твой голос уже не держит. | На ложной предпосылке сигнал калибровки ломается. | Найденный фрагмент почти не улучшает ответ. |
| Что сделать тебе | Сравни два прогона одного текста запроса. | Назначь владельца и запиши критерии приёмки. | Сверь отдельные фразы со своими правилами. | Не путай сводку графа со своим голосом. |
Короткий выбор: сначала собери базу и сам прими черновик, если своих правил в окне нет. Цифра и граф остаются подсказкой, пока критерии не записаны.
Что дальше
- Прогони один запрос дважды в чистых сессиях и сравни, что попало в окно.
- Выпиши правила, которые ты заново вставляешь в каждый новый вызов.
- Сложи свои кейсы, формулировки и запреты в одну базу и напиши имя владельца.
- Задай критерии готового текста и прими следующий черновик только по ним.
- Отложи чужую оценку и граф, пока фрагмент не сверен с твоими правилами.
Если ядро ещё не собрано вне чата, рядом есть разбор когда эксперту нечего писать без ядра и как принимать свои фрагменты без регалий.
Дальше по этой теме смотри сайт Сам себе инженер и материалы на Дзене.
Частые вопросы
Почему вчерашний текст сегодня звучит иначе в новом чате?
Модель не хранит состояние между отдельными запусками. Память о фактах, поиск по документам и кеш похожих ответов это разные задачи. Так написано в разборе стека Яндекса от 13 августа 2026. Сравни оба ответа и отметь, какого правила не хватило.
Насколько заявленное длинное окно совпадает с рабочей длиной?
В NoLiMa на ICML 2025 у 11 из 13 моделей на 32 тысячах токенов результат падает. Окно у них заявлено от 128 тысяч токенов. Без буквального совпадения слов короткая удача не держится. GPT-4o там снижается с 99,3% до 69,7%, игла при этом синтетическая.
Стоит ли верить одной оценке уверенности на весь ответ?
Словесная уверенность при внешних фрагментах плохо откалибрована. Средняя ошибка выше 0,4 на четырёх наборах в препринте Liu и соавторов. Одна цифра на весь ответ смешивает верное и неверное. На ложной предпосылке сигнал ломается, пишут Abbasli и соавторы в августе 2026.
Кто решает, что база ответов клиентам уже устарела?
Карим из NODA пишет, что база ответов клиентам протухает без владельца. Нужна и живая приёмка, иначе записи стареют. Квартал он сам называет типичным горизонтом практики, не константой измерения. Назначь владельца у себя и решай обновление по своим материалам.