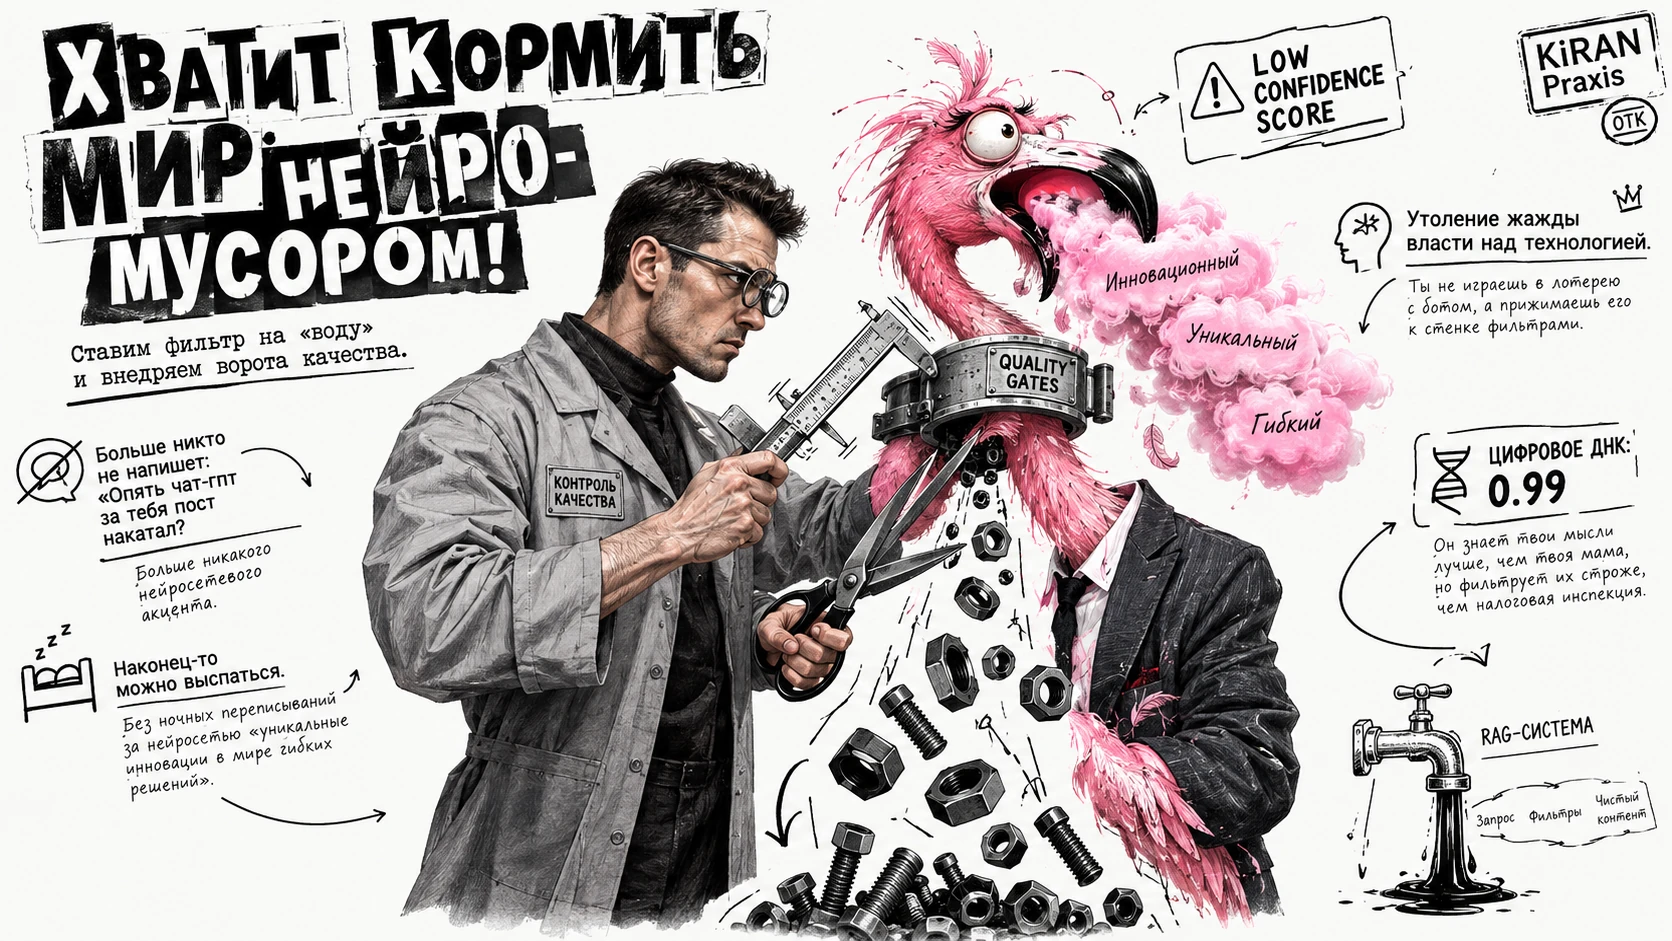
Большая языковая модель – это вероятностный двигатель, а не магический оракул. Качественный контент создается через управление допусками: настройку системного контекста, внедрение RAG-систем для фактчекинга и установку «ворот качества» (Quality Gates). Это превращает генерацию текста в контролируемый технологический процесс с нулевым уровнем брака.
Большинство экспертов в 2026 году продолжают «играть в лотерею» с нейросетями, получая водянистые тексты и галлюцинации, которые стыдно показать коллегам. Мы привыкли думать, что ИИ «умный» и сам поймет, что нам нужно, но на деле технология генеративного ИИ требует дисциплины заводского инженера, а не вдохновения художника. Если вы до сих пор удивляетесь, почему нейросеть пишет как вчерашний выпускник курсов копирайтинга, значит, ваши «допуски» слишком широки.
Я покажу, как внедрить инженерный подход и «цифровое ДНК» автора в ИИ-ассистента, чтобы масштабировать вашу экспертизу без потери уникального стиля и точности данных. Мы перейдем от случайных результатов к системе, где контроль качества ИИ становится автоматическим и предсказуемым. Это ваш билет в мир, где контент работает на статус, а не подрывает его нелепыми ошибками.
Контроль качества ИИ в 2026 году: почему промпты больше не магия, а технология управления допусками
Когда инженер проектирует деталь, он задает допуски – разрешенные отклонения от идеала. В работе с текстами мы делаем то же самое. Если вы даете нейросети полную свободу, она выбирает наиболее вероятные, а значит, самые банальные слова. Моя задача как инженера-технолога контента – сузить это поле вероятностей так, чтобы у модели просто не осталось шанса на «брак».
Входной контроль и «Цифровое ДНК»: как негативные фильтры защищают авторский стиль
Качественный контент на 90% зависит от строгости входных ограничений. В 2026 году критически важно использовать негативные промпты не просто как вежливые пожелания, а как жесткие семантические фильтры. Это фундамент вашего цифрового ДНК. Если вы не запретили использовать слова «инновационный», «уникальный» или «гибкий», приготовьтесь к порции текстового мусора. Мы внедряем табу на определенные клише, чтобы вытащить наружу живую экспертизу.
Для настройки семантических фильтров я использую следующий чек-лист входного контроля:
- Список стоп-слов (маркетинговый мусор, инфобиз-лексика, пустые прилагательные).
- Параметры глубины метафор (запрет на «кофе» как метафору энергии или «кашу» как описание неразберихи).
- Уровень технической сложности (целевой индекс читаемости для конкретной аудитории).
- Структурные запреты (например, табу на симметричные конструкции «не только, но и»).
- Тональность (запрет на пафос, искусственную восторженность и агрессивные продажи).
Автоматизированные «ворота качества»: зачем вашему контенту нужен Confidence Score
Современные агенты калибровки теперь умеют делать то, что раньше делал только живой редактор: сомневаться. Мы внедряем Quality Gates – этап, на котором ИИ самостоятельно оценивает уверенность (Confidence Score) в каждом утверждении перед выдачей результата. Это количественный показатель в диапазоне от 0.0 до 1.0. Если оценка ниже 0.85, система не выдает текст, а уходит на цикл саморефлексии или уточняющего поиска.
Типичная система «ворот качества» состоит из трех компонентов:
- Агент-верификатор: проверяет текст на соответствие заданному цифровому ДНК.
- Счетчик логических связей: ищет скрытые галлюцинации через сопоставление тезисов.
- Калибратор уверенности: выставляет итоговый балл (Confidence Score), который служит пропуском для публикации.
В 2026 году качество вашего контента на 90% определяется не тем, что вы просите ИИ сделать, а тем, что вы ему категорически запрещаете.
RAG-системы и актуальность данных: почему отсутствие проверки фактов – это репутационный риск
Полагаться на внутренние веса модели в вопросах, требующих актуальности на сентябрь 2026 года, – это профессиональное самоубийство. Память ИИ ограничена датой его обучения. Поэтому использование RAG-систем (Retrieval-Augmented Generation) сегодня является стандартом безопасности. Рынок таких систем растет с невероятным темпом (CAGR 49.1%), и это не случайно. Без подключения к динамической базе знаний эксперта любая нейросеть начнет фантазировать.
Ваша база знаний для RAG должна включать:
- Личный архив опубликованных статей и исследований.
- Свежие отраслевые отчеты и статистику (обновляемую в реальном времени).
- Техническую документацию и регламенты ваших продуктов или услуг.
- Записи вебинаров и выступлений, переведенные в текст.
Итеративная калибровка: превращаем правки в самообучающийся репозиторий бренда
Калибровка ИИ – это не разовая настройка, а бесконечный процесс улучшения. Когда вы правите текст вручную, вы не просто «чините» один пост. Вы создаете новое правило. В моем подходе каждое исправление индексируется в долгосрочной памяти ИИ-ассистента как приоритетный паттерн. Мы уходим от разовых правок к созданию самообучающегося репозитория вашего авторского стиля.
Теория Деминга в эпоху Lean AI: минимизация информационного шума
Я опираюсь на теорию управления качеством Эдвардса Деминга. Его концепция «Выход из кризиса» идеально ложится на работу с генеративным ИИ. Принципы Lean AI направлены на минимизацию информационного шума, оставляя только чистую ценность. Согласно исследованиям Madaan et al. (2023) о self-refinement, модели способны значительно улучшать выдачу, если процесс разделен на этапы генерации и последующей критической фильтрации.
Этапы цикла итеративной калибровки бренда:
- Шаг 0: Сбор первичных «отходов» (анализ повторяющихся ошибок в текстах ИИ).
- Шаг 1: Формирование нового правила (запрета или инструкции) в репозиторий стиля.
- Шаг 2: Тестовая генерация на контрольной выборке данных.
- Шаг 3: Верификация результата через Confidence Score.
- Шаг 4: Интеграция правила в системный контекст на постоянной основе.
Как собрать личный бренд в единую систему
Часто эксперты пытаются развивать личный бренд через разрозненные действия: то купят рекламу, то закажут дизайн, то наймут копирайтера. Но проблема обычно глубже – отсутствует единая основа, которая связывает позиционирование, услуги, контент и работу с ИИ. Без этой базы любая автоматизация лишь масштабирует беспорядок.
Я помогаю экспертам выстроить эту систему с нуля, используя инженерный подход:
- Собрать ваш опыт и смыслы в единое цифровое ДНК, которое поймет любая нейросеть.
- Разработать SEO и GEO-оптимизированный сайт или лендинг, который станет вашим главным активом, а не просто визиткой.
- Создать семантическое ядро на основе реальных запросов вашей аудитории, чтобы вас находили те, кто уже ищет решение.
- Настроить блог как автономный инструмент привлечения клиентов, где каждая статья работает годами.
- Подготовить базу знаний для ИИ, чтобы ваши ассистенты писали в вашем стиле и без фактических ошибок.
В основе моего подхода лежит KiRAN Praxis – авторская система структурирования экспертного опыта. Мы не просто создаем контент, мы строим воспроизводимую технологию вашего присутствия в сети, где сайт, поисковая стратегия и ИИ работают как единый механизм.
Заключение
Управление допусками превращает хаотичную генерацию текстов в предсказуемое производство смыслов. В эпоху перенасыщения информацией калиброванная точность становится вашим главным конкурентным преимуществом. Готовы ли вы перестать надеяться на «магию» и начать внедрять инженерный контроль в свой контент-маркетинг?
Отказ от RAG-систем сегодня – это осознанное распространение дезинформации под видом экспертного мнения.
Частые вопросы
Что такое управление допусками в работе с ИИ?Это установка жестких ограничений и параметров (системный контекст, негативные промпты, база знаний), которые сужают поле вероятности выдачи ИИ, сводя риск получения некачественного или «водянистого» контента к минимуму.
Почему негативные промпты важнее позитивных инструкций?Позитивные инструкции задают направление, но негативные фильтры отсекают банальности и клише, которые модель выбирает по умолчанию. Именно запреты формируют уникальный стиль и защищают от типичного «нейро-языка».
Как настроить Confidence Score для проверки текстов нейросети?Это реализуется через агентскую схему: одна модель генерирует текст, а вторая (или та же в режиме критика) оценивает вероятность фактической точности и соответствия стилю по шкале от 0 до 1.
Чем опасна работа с ИИ без RAG-системы в 2026 году?Модели имеют «дату отсечки» знаний. Без Retrieval-Augmented Generation ИИ будет использовать устаревшие данные или галлюцинировать, выдавая вымышленные факты за реальные, что несет огромные репутационные риски для эксперта.
Как превратить обычные правки текста в самообучающийся репозиторий стиля?Каждое ручное исправление нужно анализировать: почему ИИ ошибся? Затем это исправление формулируется как правило (например: «никогда не используй слово Х в контексте Y») и добавляется в системную базу знаний ассистента.
Что такое концепция Lean AI и как она помогает личному бренду?Это подход «бережливого ИИ», направленный на устранение любых избыточных данных, информационного шума и пустых смыслов. Он позволяет создавать контент, который несет только чистую ценность для аудитории.